Wat Robin ons leert over onze eigen kennisbank (en waarom dat eigenlijk het interessantste is)
We zijn momenteel aan het testen met Robin in TOPdesk. En je zou verwachten dat je daar vooral de AI leert. Maar wat we eigenlijk nu al leren is hoe we onze eigen kennisbank tot nu toe hebben georganiseerd.
Eigenlijk heel logisch. Robin kan alleen goed zoeken in wat we hem geven. En wat we hem geven is al jaren opgezet voor een heel ander soort zoeken.
Titels, synoniemen en het gewicht van woorden
Tot nu toe vertrouwden we erop dat gebruikers een zoekterm intikten, een lijst met resultaten kregen, en zelf het meest passende item uitpikten. Dat werkt redelijk praktisch.
Maar Robin doet iets anders. Die probeert niet alleen resultaten te laten zien. Die probeert uit al onze kennis te bepalen welk antwoord waarschijnlijk het beste bij de vraag past.
En daar worden de inconsistenties in onze naamgeving ineens veel zichtbaarder.
Neem ruimtes. We hebben kennisitems die "Ruimte" heten. Anderen "Lesruimte". En weer anderen "Collegezaal". Voor een mens zijn dat sterk gerelateerde woorden. Voor een AI die uit honderden kennisitems moet bepalen wat relevant is? Zijn dat signalen waarmee bepaald moet worden welk item het beste aansluit.
Het gevolg: wanneer iemand naar een collegezaal vraagt, kan ineens een kennisitem waarin precies dat woord prominent staat heel erg naar voren springen. Zelfs als dat kennisitem eigenlijk gewoon over alle soorten ruimtes gaat. Dan hebben we niet een probleem met de AI. We hebben een probleem met onze eigen terminologie.
Dus we maken nu een zoekwoordenboek
Niet zomaar een Excelbestand vol synoniemen waar niemand iets mee kan. Maar afspraken per onderwerp over waar we bepaalde woorden gebruiken.
Voor ruimtes bijvoorbeeld:
- Algemene term: "ruimte"
- Specifiekere termen (lesruimte, collegezaal, vergaderruimte) zetten we in de tekst en bij zoekwoorden
- Uitsluitend als het kennisitem echt alleen over collegezalen gaat, mag dat woord in de titel
Dezelfde logica voor alles. En daarmee geef je AI een veel consistenter landschap.
Niet: Leslokaal te warm, Problemen AV in collegezaal, Een zaal boeken, Toegang tot lokalen.
Maar: Ruimte – temperatuur, Ruimte – audiovisueel, Ruimte – reservering, Ruimte – toegang.
Voor een mens is het verschil miniem. Voor een systeem dat uit honderden items relevantie moet bepalen? Is het het verschil tussen helder en chaos.
Robin legt nog iets bloot: onze formuliertitels
Dit is eigenlijk nog interessanter. In de oude SSP konden formulieren “títelloos” zijn, omdat de tegel erboven alle context gaf. Tegel: "Storing melden", formulier eronder: "Ruimte". Logisch.
Maar Robin haalt het formulier uit die context. De gebruiker stelt een vraag ("De beamer doet het niet"), en Robin raadt een formulier aan. En ineens is die titel veel belangrijker. Omdat die gebruiker niet ziet in welke tegel het formulier toevallig staat.
"Ruimte" zegt niet of je iets aanvraagt of een storing meldt. Of je een beamer reserveert of een probleem rapporteert.
De context zat in de tegel. Robin heeft die context niet.
Dus formuliertitels moeten voortaan zelfstandig begrijpelijk zijn. "Ruimte – storing melden", "Ruimte – wijziging aanvragen", "AV-apparatuur – storing". In één oogopslag duidelijk waar het over gaat én wat je ermee doet.
AI maakt zichtbaar wat al jaren niet optimaal was
En dat is misschien wel het interessantste van deze hele oefening.
Iedereen kijkt naar vragen als: "Geeft Robin het juiste antwoord? Hallucineert de AI niet?" echt Legit vragen. Maar wat de bèta ons echt leert is dat we minstens zo goed naar onze eigen informatiearchitectuur moeten kijken.
Want AI gebruikt wat wij hebben ingericht. Als wij drie verschillende woorden voor hetzelfde onderwerp gebruiken, moet AI daar betekenis uit proberen te halen. Als een formuliertitel alleen logisch is omdat hij onder de juiste tegel staat, kan Robin dat niet zomaar terugtoveren.
AI maakt die inconsistenties vooral zichtbaar. Het dwingt ons om vragen te stellen die we eigenlijk al eerder hadden moeten stellen:
- Waarom heet dit hier "ruimte" en daar "collegezaal"?
- Waarom gebruiken we "BI" in het ene stuk en "Power BI" in het andere?
- Kan iemand aan een formuliertitel zien wat-ie ermee doet?
- Waarom staat belangrijke informatie alleen in een formulier en niet in een kennisitem?
- Gebruiken all onze kennisitems over hetzelfde onderwerp dezelfde basiswoorden?
Dus we gaan breder opruimen
We gaan niet alleen Robin testen. We gaan tegelijkertijd naar:
- Titels van kennisitems.
- Termen die we consequent willen gebruiken.
- Synoniemen.
- Zoekwoorden.
- Inhoud van kennisitems.
- Koppeling tussen items en formulieren.
- Formuliertitels. Het verschil tussen aanvragen, melden en informatie zoeken.
Dat zoekwoordenboek wordt per onderwerp iets als:
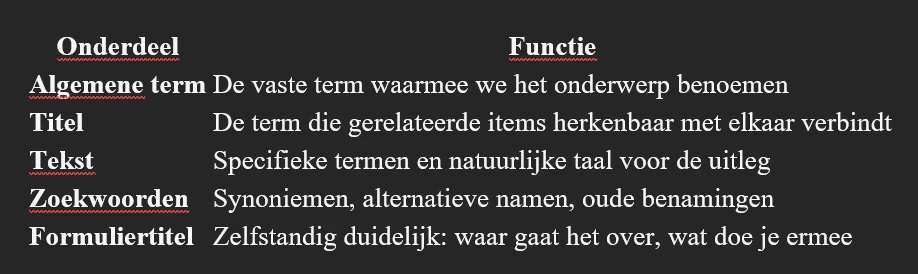
En die laatste regel is voor ons echt een nieuwe basisregel geworden: een formulier moet begrijpelijk zijn ook als je de tegel erboven niet kunt zien.
Van zoeken naar begrepen worden
Voorheen dachten we vooral: "Kan een gebruiker dit vinden?"
Nu hebben we een tweede vraag: "Kan het systeem begrijpen dat dit de juiste kennis is om te tonen?"
Dat vraagt om meer consistentie. Niet omdat AI alleen maar exact dezelfde woorden kan gebruiken AI Search is echt bedoeld om semantisch naar kennis te zoeken. Maar semantisch zoeken betekent niet dat naamgeving ineens onbelangrijk wordt. Integendeel.
Hoe consistenter wij onze onderwerpen en formulieren beschrijven, hoe duidelijker de informatie waaruit het systeem zijn antwoord moet samenstellen. Daardoor voorkom je dat één item onbedoeld veel relevanter lijkt puur omdat iemand jaren geleden toevallig een ander woord in de titel zette.
Onze grootste les tot nu toe
Robin dwingt ons niet alleen om beter te testen. Robin dwingt ons om beter na te denken. Over onze eigen spullen.
En eigenlijk is dat misschien wel groter dan Robin zelf. Want uiteindelijk kan geen systeem AI of niet goed zoeken in informatie die wij inconsistent hebben ingericht.
Maar als wij die informatie consequent, herkenbaar en logisch organiseren? Dan wordt niet alleen Robin er beter van. Onze normale zoekfunctie wordt beter. Onze SSP wordt duidelijker. Onze gebruikers vinden sneller wat ze nodig hebben.
Dat is eigenlijk waar we al die tijd naartoe wilden.